深色模式
整理配置
文件整理的全局默认值都在这里:识别缓存、媒体信息提取、通知模板、元数据策略、重命名模板、二级分类、预设、OpenAI 辅助与词表。
前置条件
- 已能在 NanShare 左侧菜单进入「文件整理 → 整理配置」。
- 想改的是全局默认值;单条整理任务的源目录、目标目录、整理方式在「整理监控」里配置。
页面结构
一级三个标签:
| 标签 | 作用 |
|---|---|
| 基础配置 | 缓存、媒体信息提取、整理通知、元数据下载策略 |
| OpenAI 辅助 | AI 辅助识别的基础配置与提示词 |
| 词表 | 识别词、制作组、渲染后处理词、捕获词、导入导出 |
「基础配置」下还有五个二级标签:
| 二级标签 | 作用 |
|---|---|
| 基础配置 | 上面四张卡片 |
| 重命名设置 | 电影 / 电视剧重命名模板 |
| 二级分类设置 | 全局二级分类规则 |
| 重命名预设 | 可复用的命名模板集合 |
| 二级分类预设 | 可复用的分类规则集合 |
两种「基础配置」
一级标签和二级标签同名,指的不是同一层:一级的「基础配置」包含五个二级标签,二级的「基础配置」只包含四张设置卡片。
基础配置
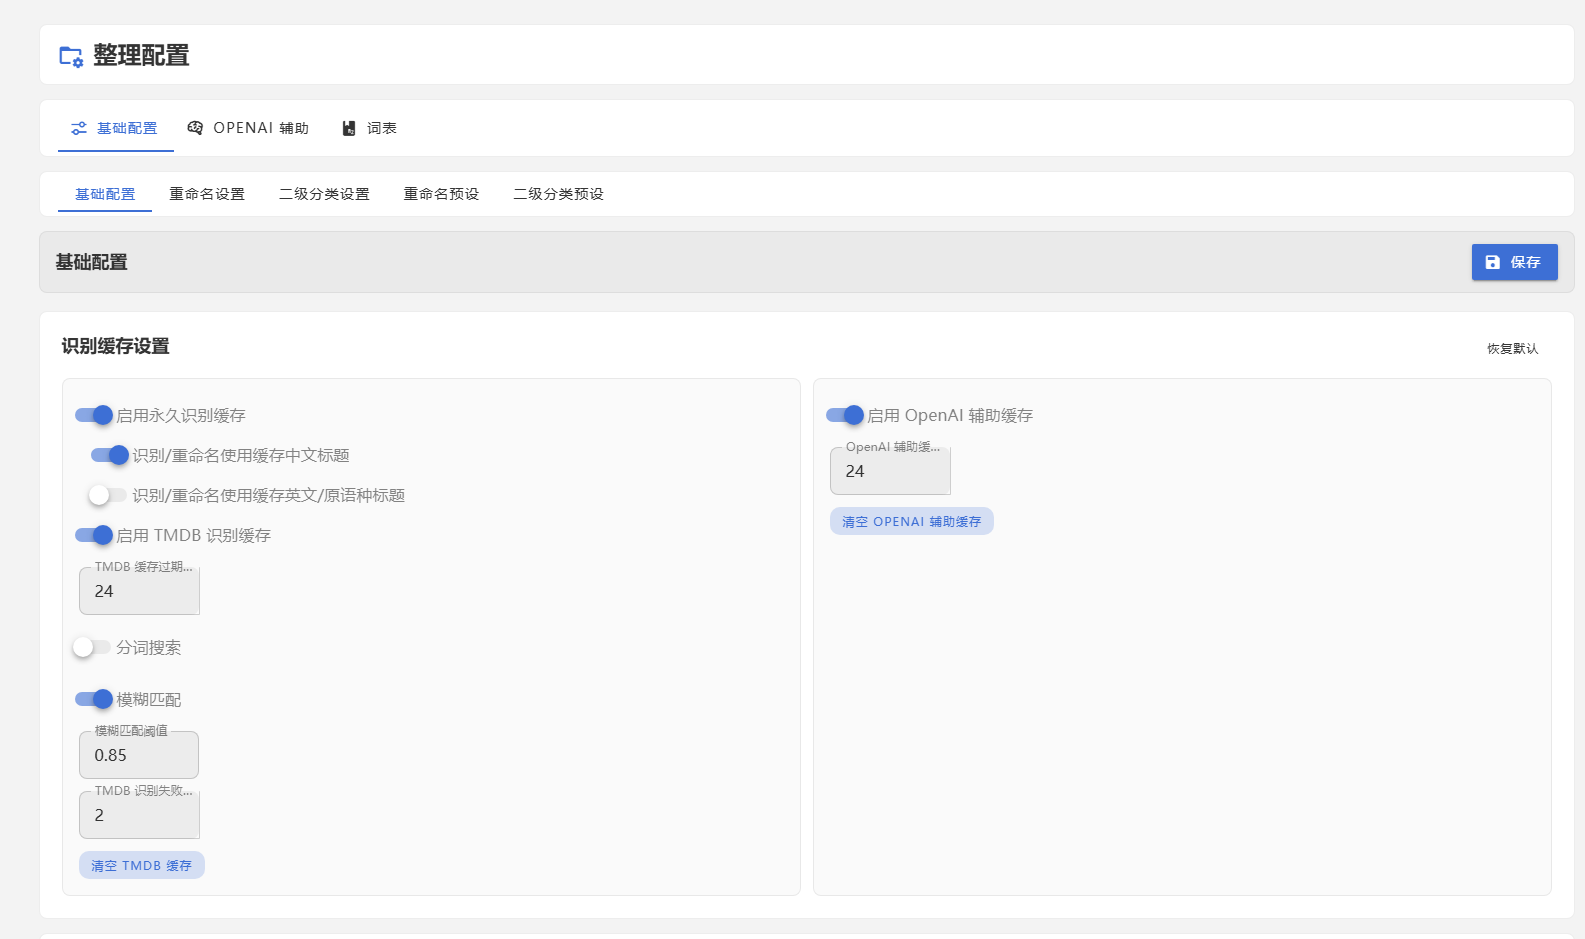
识别缓存设置
| 设置 | 默认 | 说明 |
|---|---|---|
| 启用永久识别缓存 | 关 | 命中永久缓存时直接复用识别结果 |
| 识别/重命名使用缓存中文标题 | 开 | 依赖永久缓存总开关 |
| 识别/重命名使用缓存英文/原语种标题 | 关 | 依赖永久缓存总开关 |
| 启用 TMDB 识别缓存 | 开 | 减少重复请求 TMDB |
| TMDB 缓存过期时间(小时) | 24 | 最小 1 |
| 分词搜索 | 关 | 把标题拆词后再匹配 |
| 模糊匹配 | 开 | 标题不完全一致时也尝试匹配 |
| 模糊匹配阈值 | 0.85 | 0–1,越小越宽松 |
| TMDB 识别失败缓存时间(分钟) | 2 | 失败结果也缓存,避免短时间重复请求 |
| 清空 TMDB 缓存 | — | 立即清空,不可恢复 |
| 启用 OpenAI 辅助缓存 | 开 | 缓存 AI 识别结果 |
| OpenAI 辅助缓存时间(小时) | 24 | 最小 1 |
| 清空 OpenAI 辅助缓存 | — | 立即清空,不可恢复 |
「恢复默认」只重置这一张卡片的缓存项,不会动通知和元数据策略。
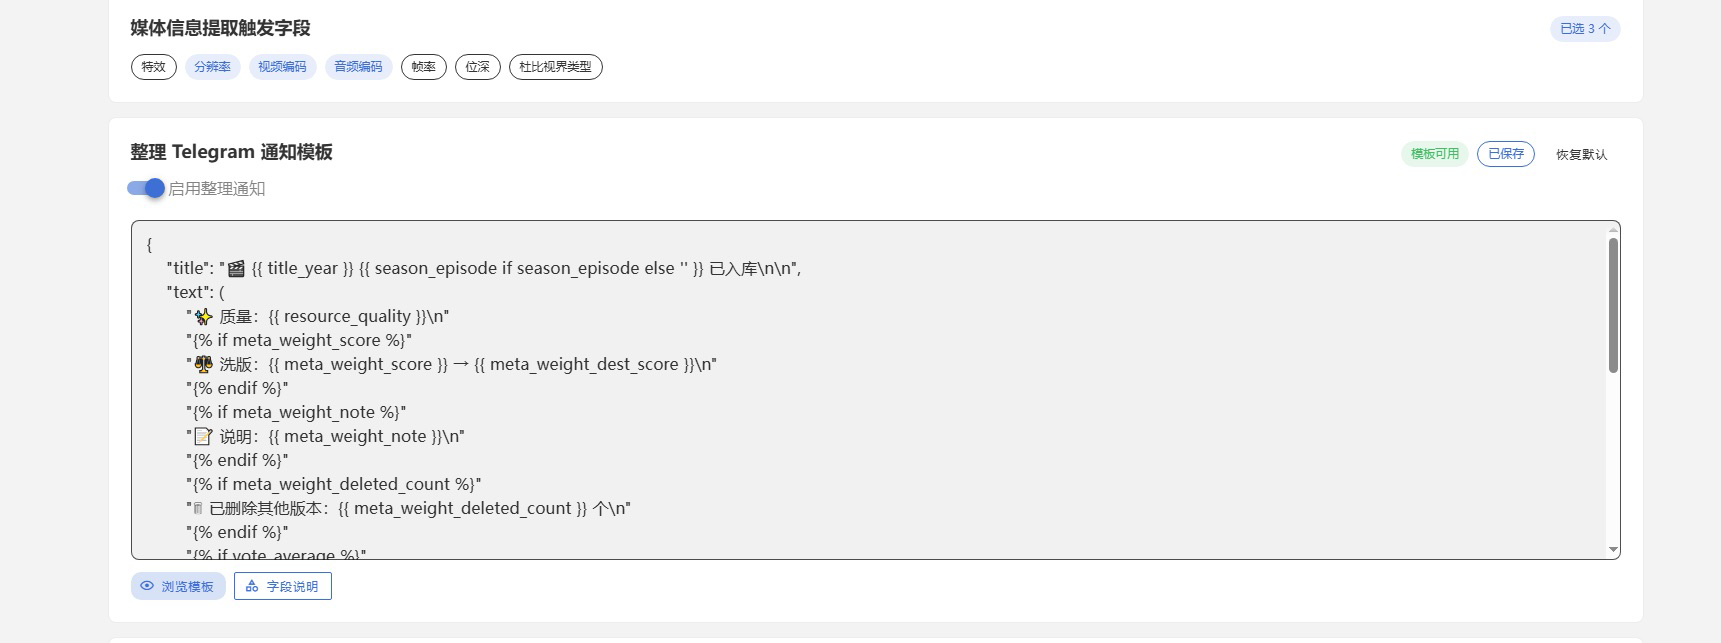
媒体信息提取触发字段
选择哪些字段缺失时才触发 ffprobe 提取,默认是视频格式、视频编码、音频编码。可选项:
text
effect · videoFormat · videoCodec · audioCodec · fps · bitDepth · dolbyVision已选数量会显示在卡片标题旁。字段选得越多,触发提取的概率越高,整理也越慢。
整理 Telegram 通知模板
| 设置 | 默认 | 说明 |
|---|---|---|
| 启用整理通知 | 关 | 开启后整理完成/失败会推送到 TG |
| 通知模板 | 内置模板 | Gonja/Jinja2 模板,支持标题、正文、图片、链接 |
- 模板编辑后会自动校验,卡片上显示「模板可用」或「模板错误」。
- 「浏览模板」可以预览电影、电视剧两种渲染结果,并支持复制。
- 「字段说明」列出可用字段与片段,点一下即可复制。
- 「恢复默认」恢复内置模板。
通知里的「失败 / 已存在」状态不套用自定义模板,走固定文案。
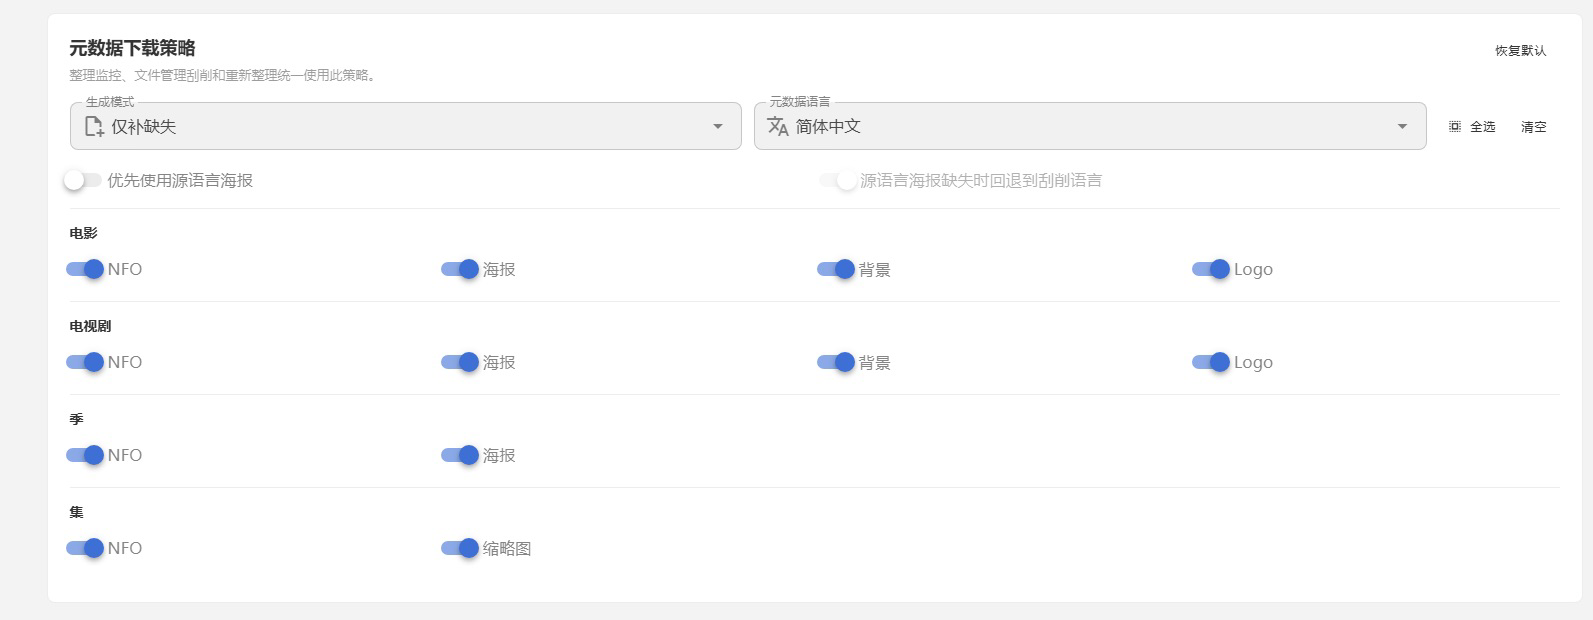
元数据下载策略
整理监控、文件管理的刮削、重新整理都统一使用这里的策略。
| 设置 | 默认 | 说明 |
|---|---|---|
| 生成模式 | 仅补缺失 | 跳过生成 / 仅补缺失 / 覆盖已有 |
| 元数据语言 | 简体中文 | 简体中文 / 繁体中文 / English / 日本語 / 한국어 |
| 优先使用源语言海报 | 关 | 有原语种海报时优先使用 |
| 源语言海报缺失时回退到刮削语言 | 开 | 上一项关闭时不可用 |
产物开关分四组,默认全开:
text
电影:NFO · 海报 · 背景 · Logo
电视剧:NFO · 海报 · 背景 · Logo
季:NFO · 海报
集:NFO · 缩略图
「全选」「清空」只切换产物开关,不改生成模式、语言和海报回退开关。
重命名设置
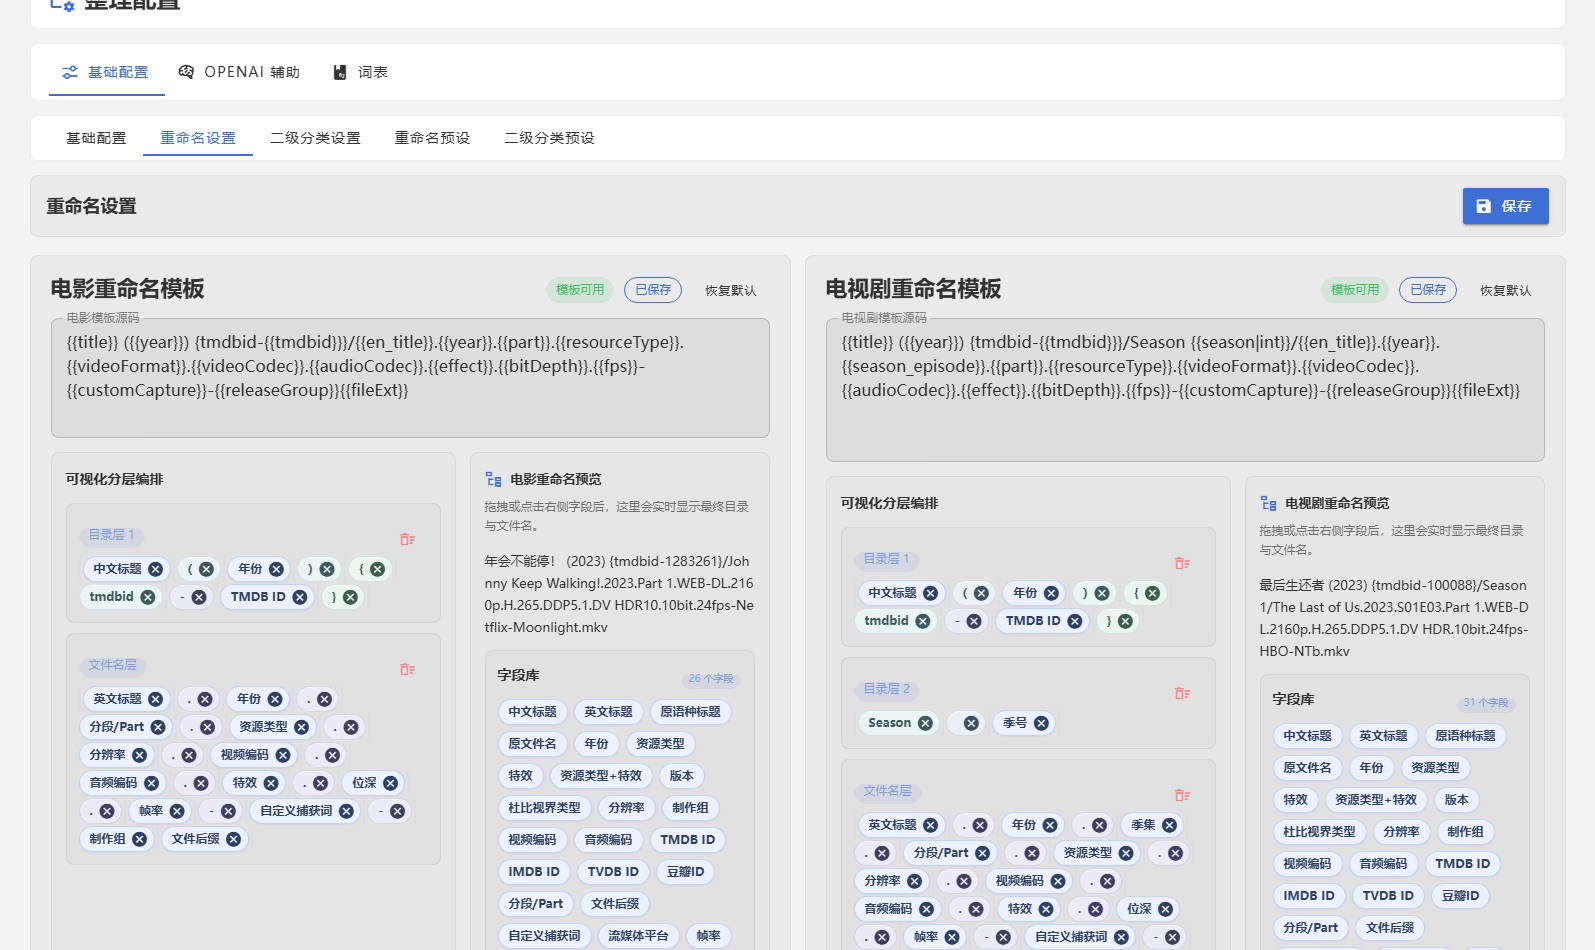
电影和电视剧各一张卡片,包含三部分:
- 模板源码:直接编辑模板文本,卡片上会显示「模板可用 / 模板错误」。
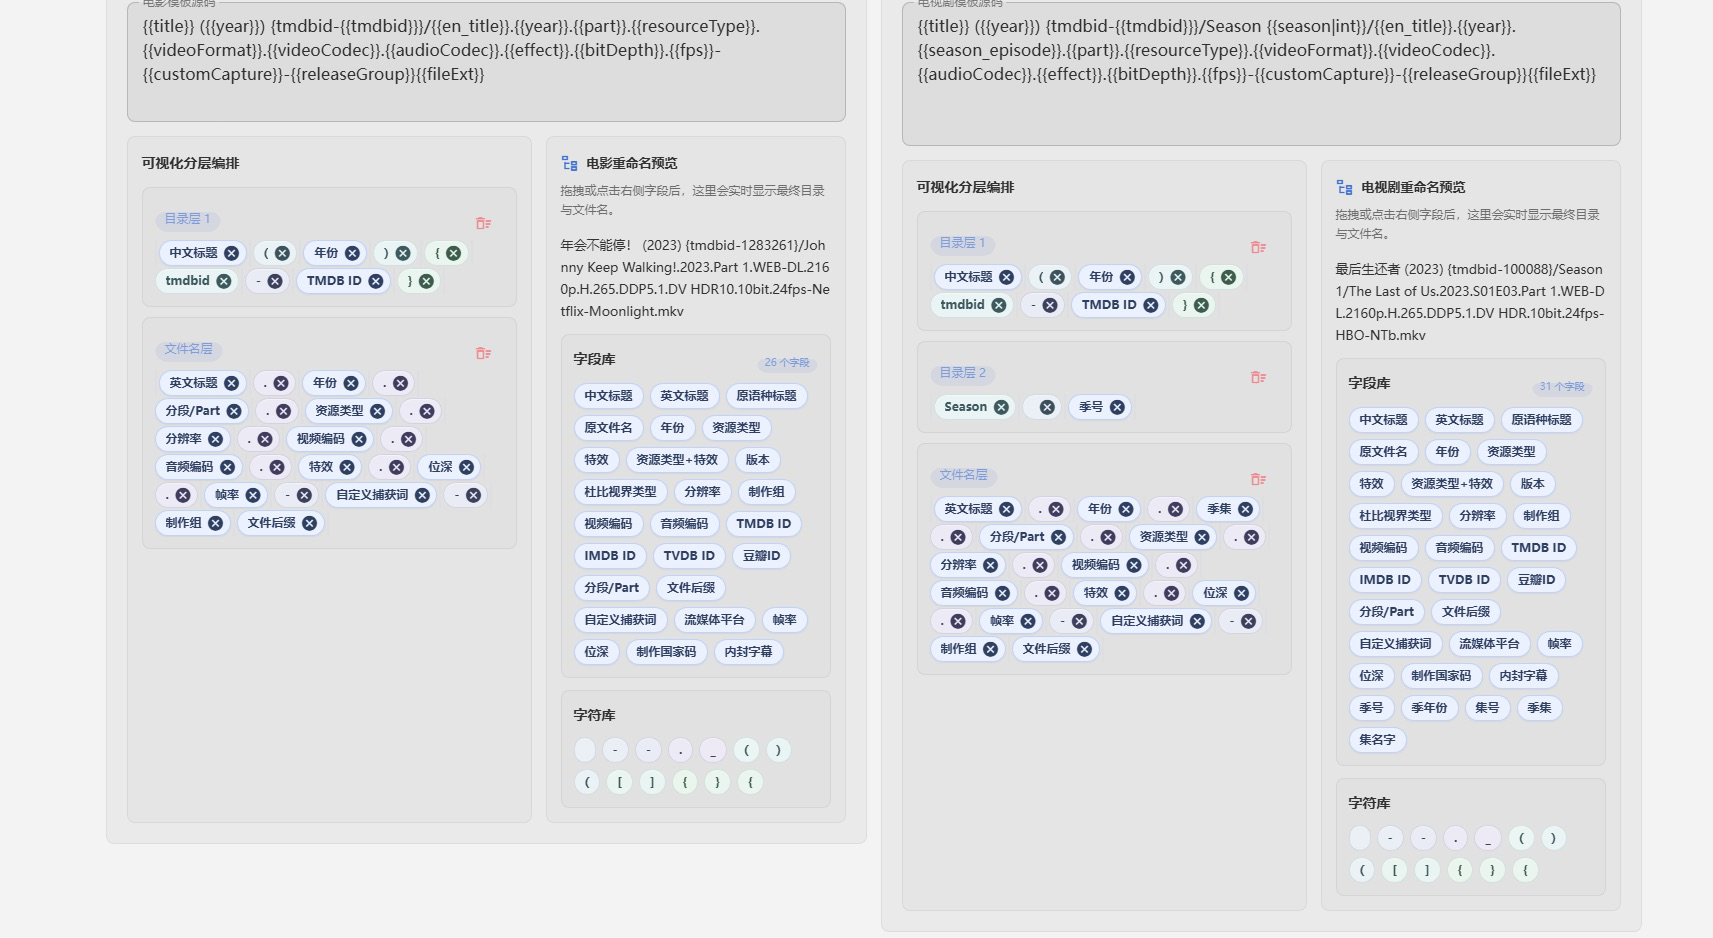
- 可视化分层编排:电影两层、电视剧三层,最后一层是「文件名层」,其余是「目录层」;可以拖拽字段或字符到任意位置。
- 预览:实时显示最终目录与文件名。
下方是「字段库」和「字符库」:点字段会追加到最后一层,字符库提供空格、短横线、点号、括号等常用分隔符。
- 模板改动后约 280ms 自动校验,没有单独的「校验」按钮。
- 模板和基础配置共用同一个保存动作:在「重命名设置」里点保存,会把缓存、通知、元数据一起保存。
二级分类设置
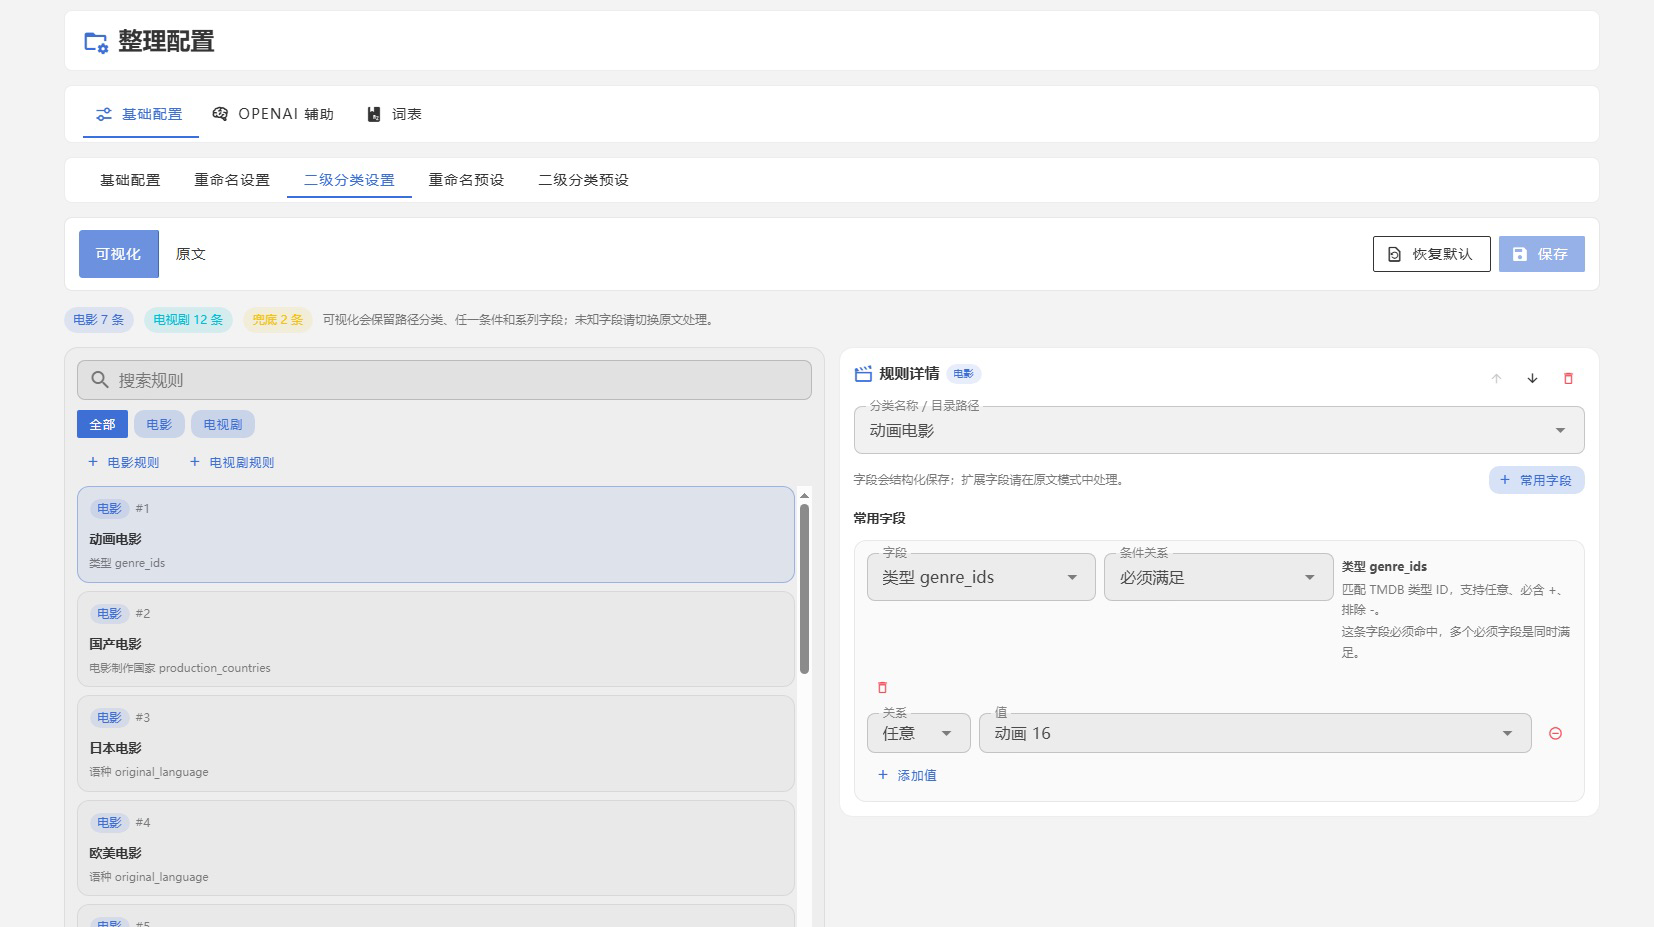
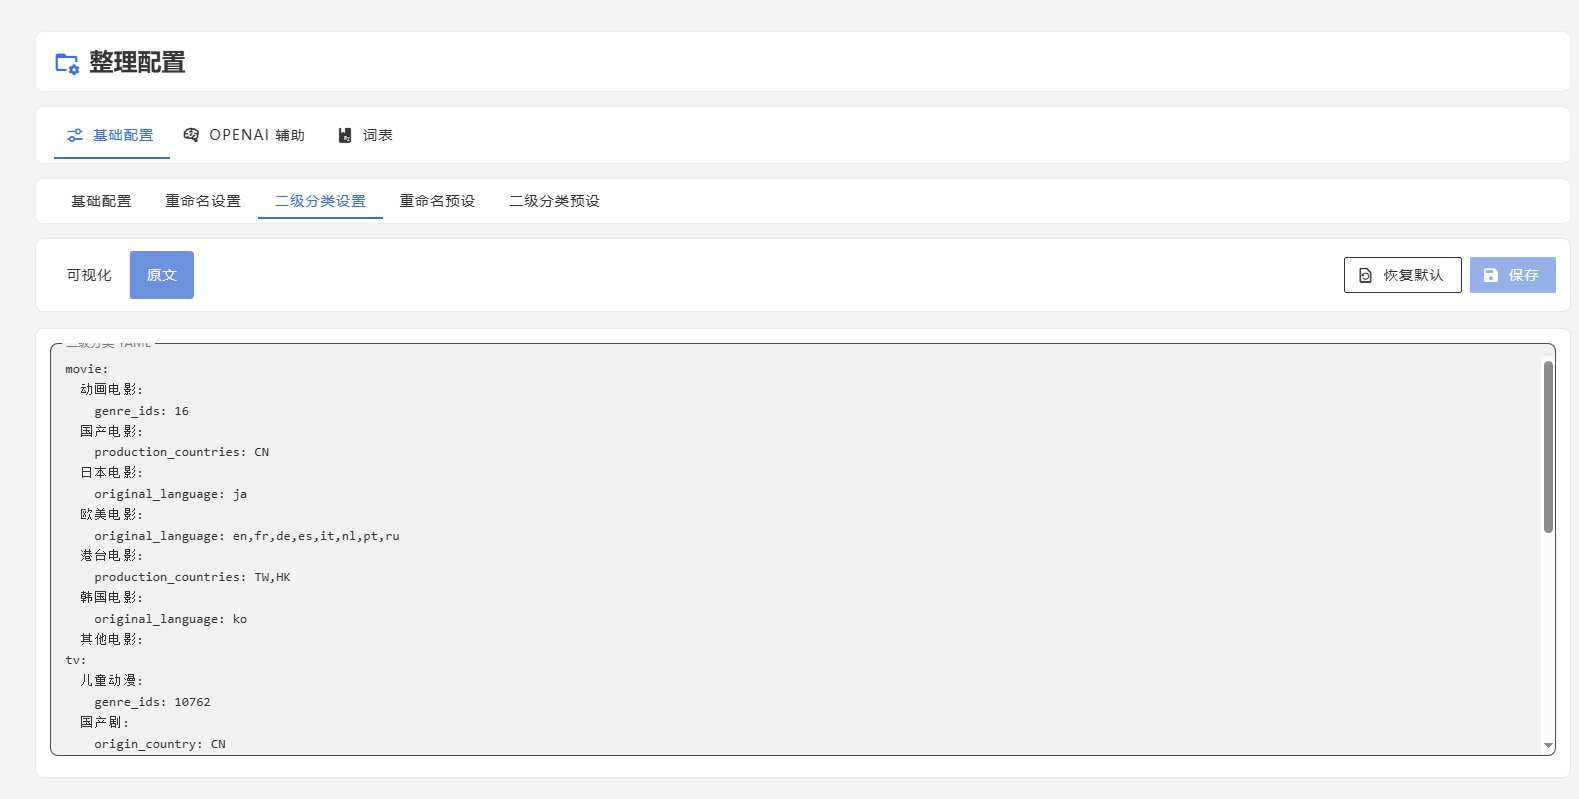
- 支持「可视化」和「原文」两种编辑方式;切换前会先校验,校验不通过不能切换。
- 可视化模式按电影 / 电视剧分栏,可新增规则、上移下移、删除;兜底规则会自动排到最后。
- 原文模式直接编辑 YAML,适合处理扩展字段。
- 「恢复默认」只是把默认配置载入原文模式,不会自动保存,仍需校验后手动点保存。
- 这里保存的是全局分类规则;给单条整理配置选分类规则,在「整理监控」里选「二级分类预设」。
规则支持十个字段(完整语法见 二级分类):
| 字段 | 说明 |
|---|---|
genre_ids | TMDB 类型 ID,支持 + 必含、- 排除 |
original_language | 原始语言 |
production_countries | 电影制片国家/地区 |
origin_country | 剧集国家/地区 |
release_year | 发行/首播年份,支持区间 |
keywords | 标题、原名、英文名、别名关键词 |
include_keywords | TMDB 标签关键词 |
series_keywords | 按标题关键词生成系列子目录 |
series_actors | 按演员生成系列子目录 |
series_directors | 按导演生成系列子目录 |
重命名预设
- 列表展示每套预设的名称、ID、电影/剧集模板是否已配置。
- 可以新建、编辑、删除;没有复制和排序,顺序以后端返回为准。
- 预设不会自动生效,必须被「整理监控」的整理配置、快速识别或重新整理引用。
二级分类预设
- 与「重命名预设」结构相同:新建、编辑、删除,无复制和排序。
- 编辑弹窗支持可视化与原文两种方式,保存前会强制校验。
- 同样需要被单条整理配置引用才会生效。
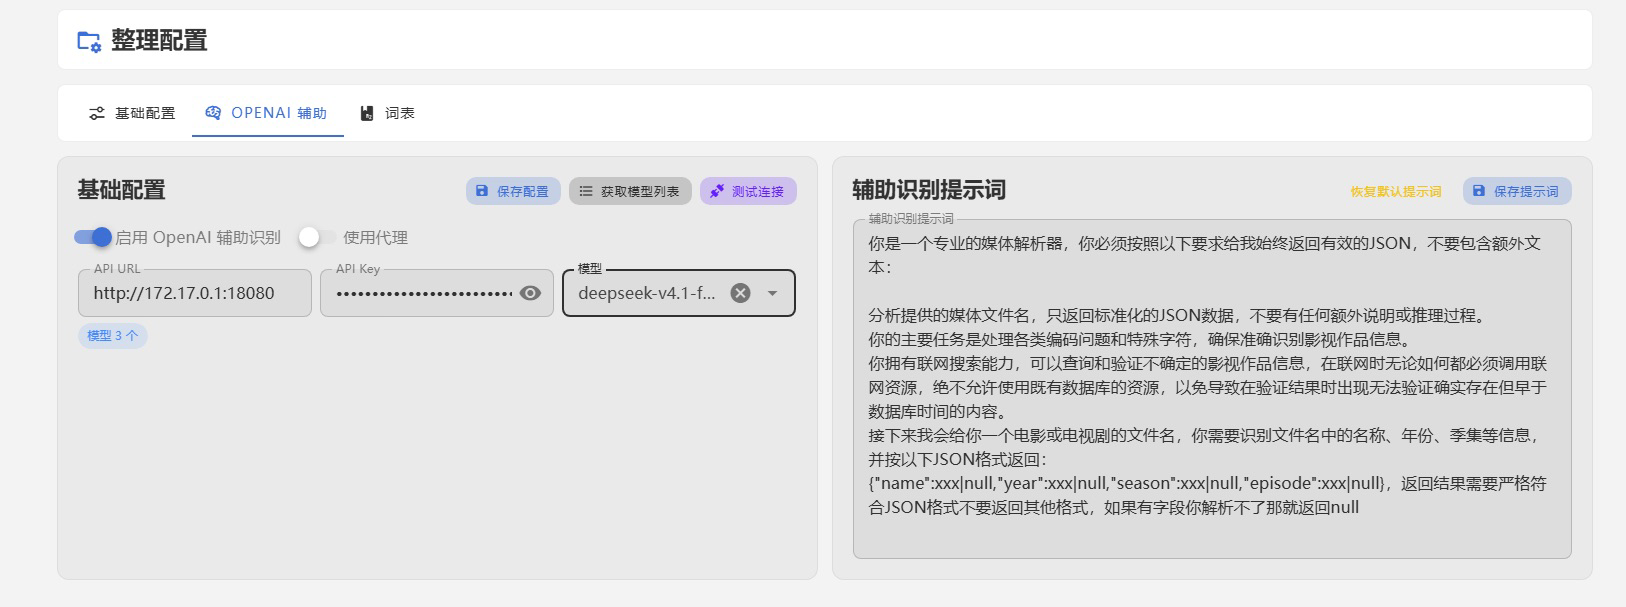
OpenAI 辅助
基础配置
| 设置 | 默认 | 说明 |
|---|---|---|
| 启用 OpenAI 辅助识别 | 关 | 开启后规则识别失败时可走 AI |
| 使用代理 | 关 | 走设置里的全局代理 |
| API URL | 空 | 例如 https://api.openai.com |
| API Key | 空 | 只保存在本地配置 |
| 模型 | 空 | 先「获取模型列表」,再从下拉里选 |
- 「获取模型列表」只需要 API URL 和 API Key。
- 「测试连接」需要 URL、Key、模型都填好。
- 「保存配置」只保存这五项,不含提示词。
辅助识别提示词
- 文本框里是系统提示词,可自定义。
- 「恢复默认提示词」只把内容改回默认,不会自动保存。
- 「保存提示词」单独保存,与基础配置分开。
内嵌时没有未保存提示
从「整理配置」进入时,OpenAI 辅助不显示「有未保存变更」的提示;改完要自己记得点保存。
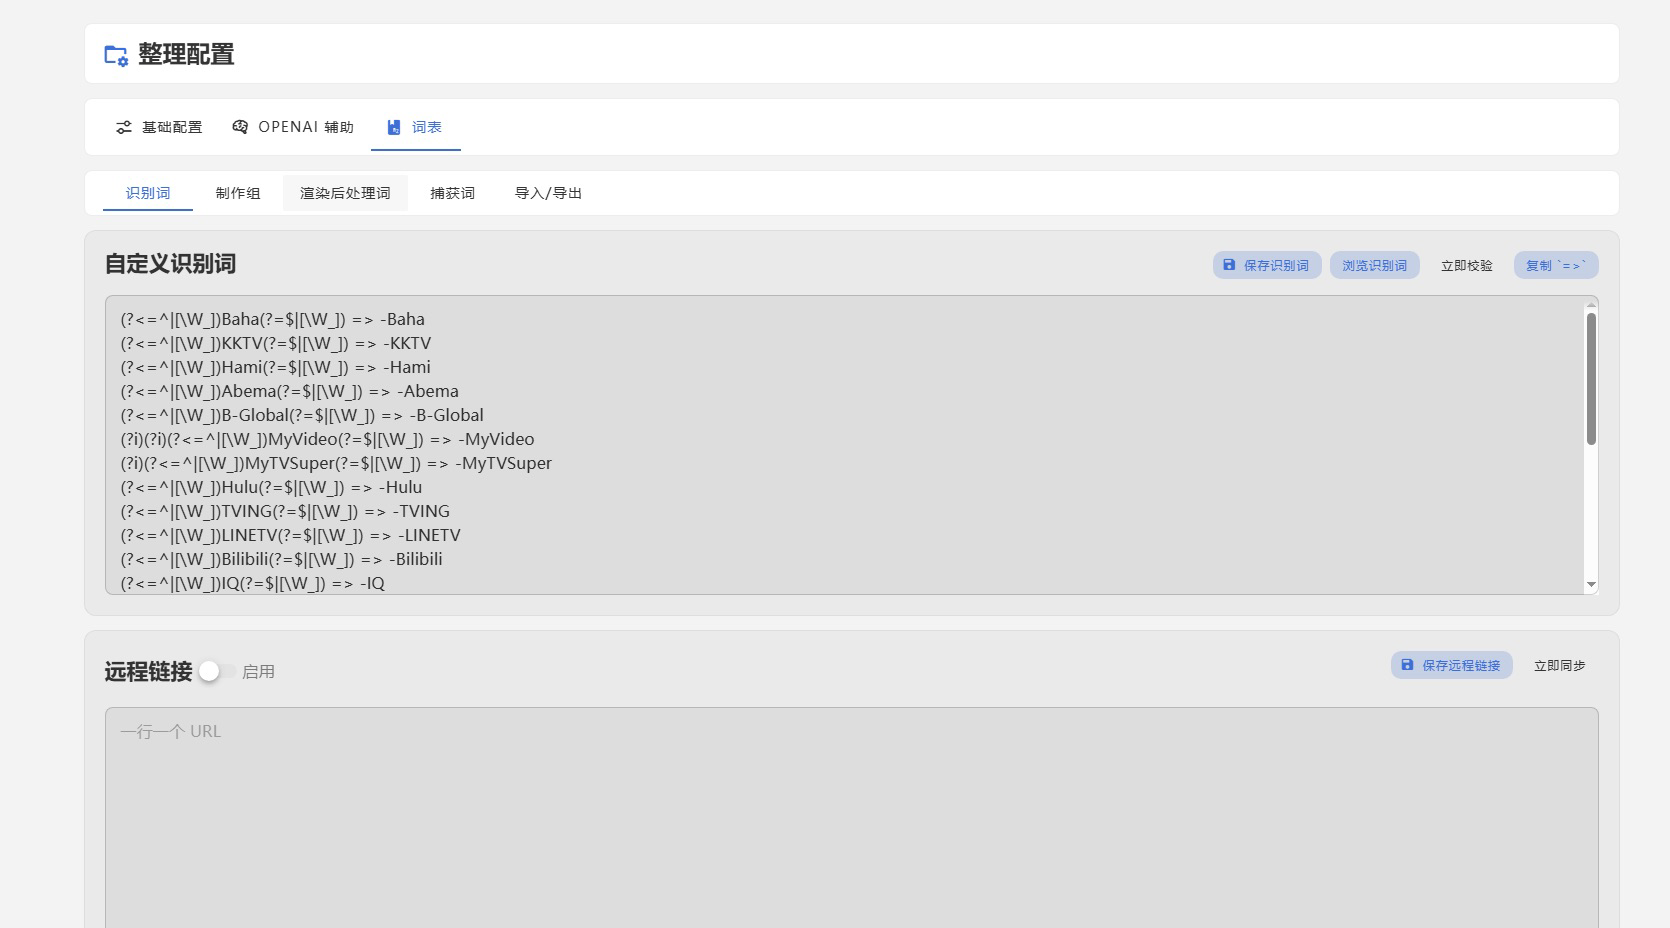
词表
五个二级标签:
| 标签 | 内容 |
|---|---|
| 识别词 | 名称解析前的替换、偏移、指定 TMDB |
| 制作组 | 压制组 / 字幕组 / 发布组识别 |
| 渲染后处理词 | 渲染完成后的替换与清理 |
| 捕获词 | 从文件名提取自定义变量 |
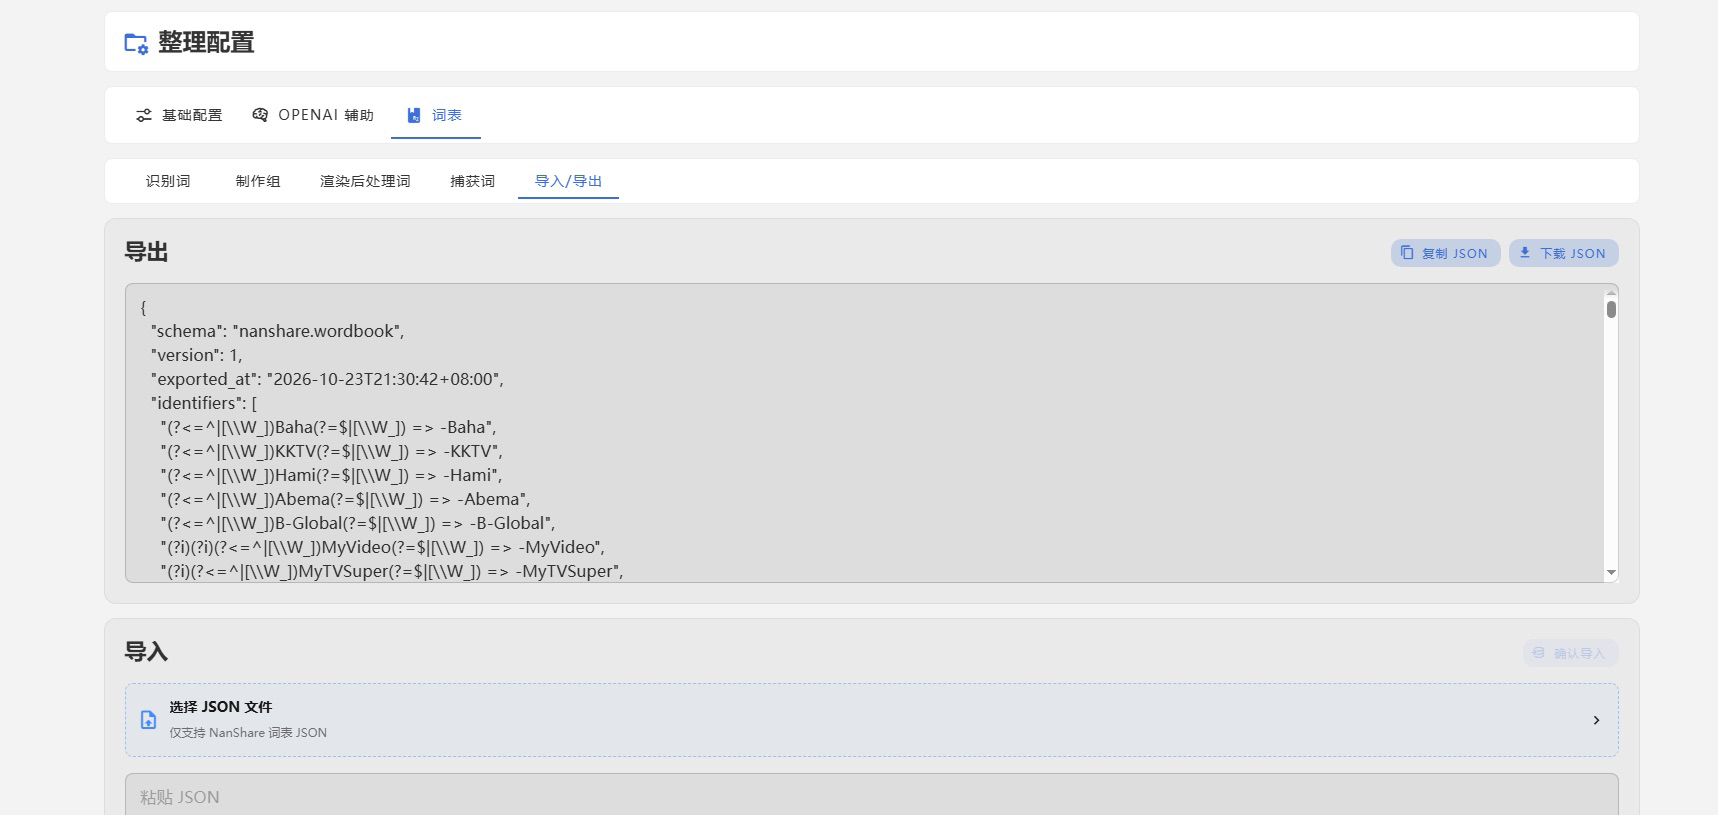
| 导入/导出 | 词表 JSON 的导出与导入 |
- 每个词表页都有「立即校验」;保存前也会自动校验,语法错误会阻止保存。
- 「远程链接」可以填多个 URL,开启后与本地词表合并,远端行只读。
- 导入时会按类型预览「追加多少、跳过多少」,重复判断基于当前已保存的词表。
具体语法见「语法参考」里的识别词与词表子页。
保存与校验一览
| 区域 | 保存按钮 | 是否独立保存 | 校验方式 |
|---|---|---|---|
| 基础配置 + 重命名设置 | 保存 | 两者共用一份 | 模板自动校验(约 280ms) |
| 二级分类设置 | 保存 | 独立 | 自动校验 + 保存前强制校验 |
| 重命名预设 | 保存预设 | 独立 | 保存前校验 |
| 二级分类预设 | 保存预设 | 独立 | 自动校验 + 保存前强制校验 |
| OpenAI 基础配置 | 保存配置 | 独立 | 测试连接 / 获取模型 |
| OpenAI 提示词 | 保存提示词 | 独立 | 无 |
| 词表 | 保存识别词等 | 每种词表独立 | 立即校验 + 保存前校验 |
容易误解的地方
- 基础配置和重命名设置是一份保存:在任一标签点保存,都会提交缓存、通知、元数据、模板的当前值。
- 二级分类设置的「恢复默认」不落盘:只是载入草稿,仍需保存。
- 预设不能复制、不能排序:只有新建、编辑、删除。
- 整理配置不是整理任务:这里只放全局默认值,源目录/目标目录/整理方式仍在「整理监控」。
- 切标签不会丢草稿:页面会保留各标签的未保存内容,但离开页面前记得保存。