深色模式
永久识别缓存
识别成功把tmdbid信息缓存到数据库,文件整理或其他地方可以直接用,比如文件整理有效防止tmdb词条乱改问题
前置条件
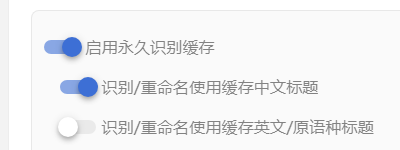
- 已在整理基础配置里开启永久识别缓存开关,缓存才会参与识别。
- 缓存数据存在 SQLite 中,不属于配置段;导入导出使用 JSON 文档。
使用流程
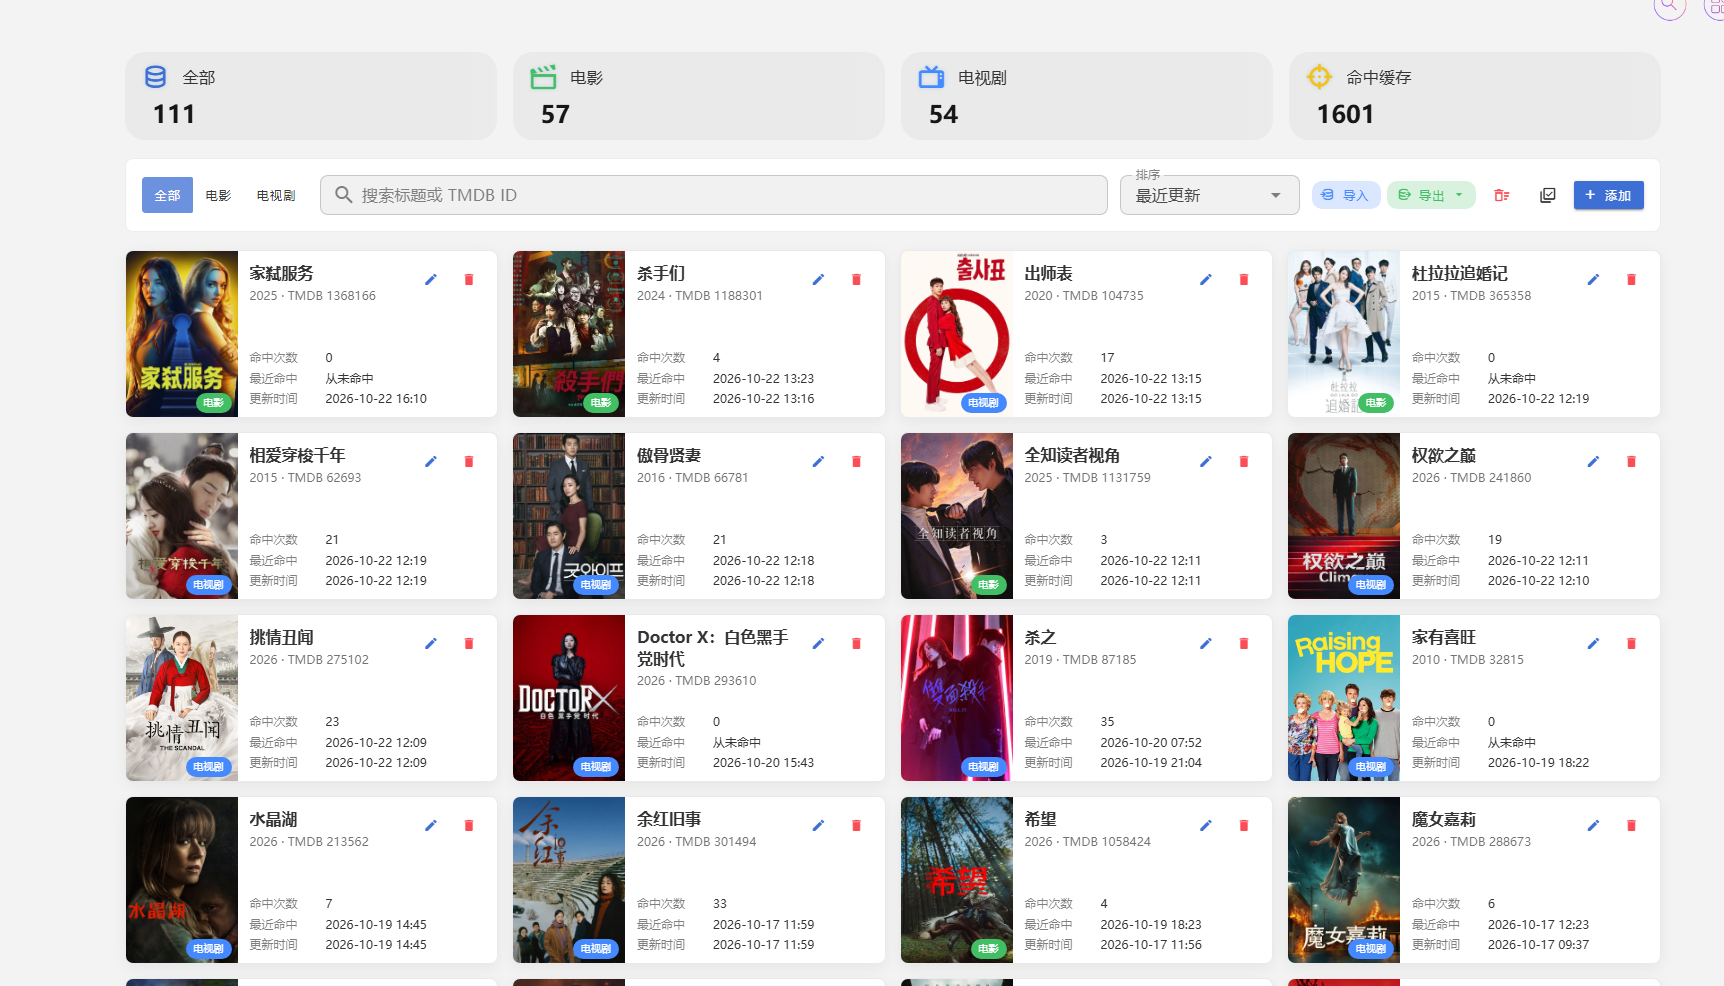
- 进入「文件整理 → 永久缓存」,顶部四张卡片展示总数、电影、电视剧与命中缓存数。
- 用类型筛选、关键词搜索(标题或 TMDB ID)与排序定位记录。
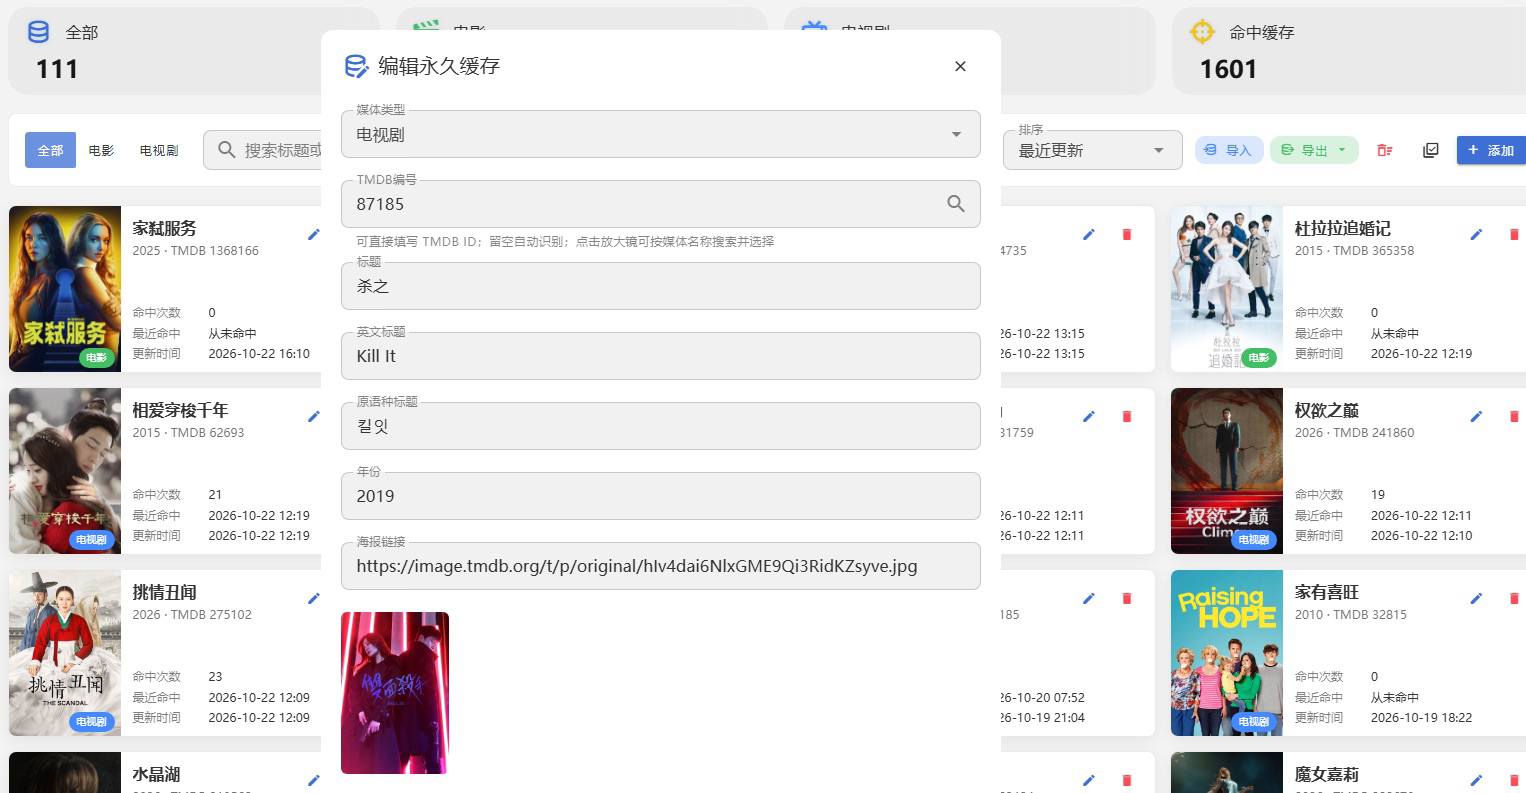
- 点「添加」新建缓存:填 TMDB ID、媒体类型、标题等,可用 TMDB 搜索带出详情。
- 点单条记录可编辑或删除;开启多选后可批量删除;顶部菜单可导出全部 / 筛选 / 选中,或清空全部。
- 「导入」选择 JSON 文件,按字段设置冲突策略后导入。
常见问题
永久缓存和普通识别缓存有什么区别?
TIP
普通 TMDB / GPT 缓存有小时级过期时间(meta_cache_expire_hours、gpt_cache_expire_hours);永久缓存长期保存,命中优先级更高,适合人工确认过的条目。
导入时字段冲突怎么处理?
TIP
导入弹窗对 title、en_title、original_title、year、poster_url 分别设置 keep 或 replace:开启的字段使用导入值,关闭的字段保留现有值。
删除缓存会删除磁盘文件吗?
TIP
不会。删除只影响永久缓存记录本身,不动源文件或媒体库文件。
导入失败提示文件类型不对?
TIP
导入文件必须是 schema 为 nanshare.permanent_recognition_cache、version 为 1 的 JSON,且 items 非空、count 与实际记录数一致。